「突然サーバーがダウンした」「不審な通信を検知した」――。企業のIT担当者にとって、このようなインシデントの発生は常に緊張が走る瞬間です。何から手をつければいいのか、どうすれば被害を最小限に抑えられるのか、頭が真っ白になることもあるかもしれません。
しかし、インシデントはいつ起こるか予測ができません。だからこそ、万が一の事態に備え、冷静かつ迅速に対応するための「型」を知っておくことが極めて重要です。
この記事では、企業のIT担当者やセキュリティ担当者の方に向けて、インシデント対応の基本から具体的なフロー、そして実効性のある体制の作り方までを網羅的に解説します。
この記事のポイント
- インシデント対応とは、業務を脅かす障害や攻撃の影響を最小限に抑え、迅速に通常状態へ復旧させるための一連の活動である。
- インシデントにはマルウェアや不正アクセスなどの「セキュリティインシデント」と、ハード故障や設定ミスなどの「システム障害」の2種類があり、遅延は事業停止や信用失墜に直結する。
- NISTのフレームワークに基づく「準備」「検知と分析」「封じ込め・根絶・復旧」「事後対応」の4フェーズを循環させながら、平時の体制づくりと有事の的確な初動を進めることが求められる。
- 実効性を高めるには、CSIRTの組織化や対応計画(IRP)の策定、定期的な演習に加え、自社リソースが不足する際は24時間365日の運用代行など外部専門サービスを活用することが有効である。
目次
インシデント対応とは?サイバー攻撃からシステム障害まで
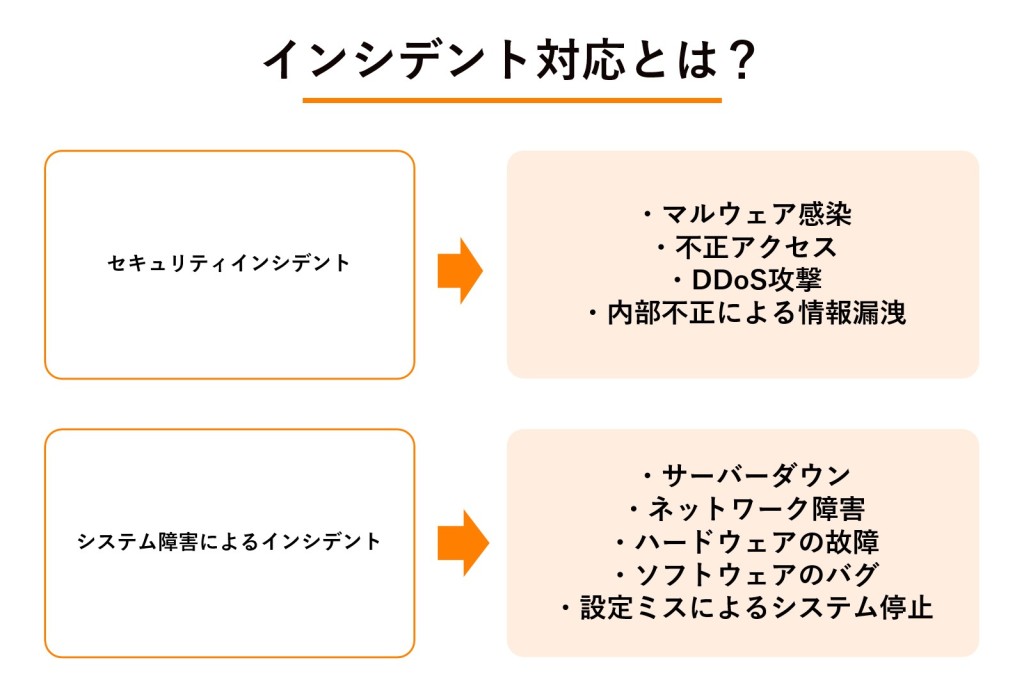
インシデント対応とは、ひとことで言えば「企業や組織の通常業務を脅かす出来事(インシデント)が発生した際に、その影響を最小限に抑え、迅速に通常状態へ復旧させるための一連の活動」のことです。インシデントレスポンスとも呼ばれます。
まずは、その定義や目的について深く理解していきましょう。
インシデントの定義と具体例
インシデントとは、システムの停止、セキュリティ侵害、情報の紛失など、事業継続に悪影響を及ぼす可能性のあるあらゆる事象を指します。特に近年では、サイバー攻撃によるセキュリティインシデントが深刻な問題となっています。
インシデントは、その原因や影響によって大きく以下の2つに分類されます。
| インシデント分類 | 具体例 |
| セキュリティインシデント | ・マルウェア感染 ・不正アクセス ・DDoS攻撃 ・内部不正による情報漏洩 |
| システム障害によるインシデント | ・サーバーダウン ・ネットワーク障害 ・ハードウェアの故障 ・ソフトウェアのバグ ・設定ミスによるシステム停止 |
これらのインシデントは、事業の停止、金銭的損失、顧客からの信頼失墜など、企業に甚大な被害をもたらす可能性があります。
インシデント対応の目的と重要性
インシデント対応の最終的な目的は、「インシデントによる被害を最小限に食い止め、事業を迅速に復旧させること」です。
もしインシデント対応が遅れたり、手順を誤ったりすると、以下のような事態に発展する可能性があります。
- 被害の拡大: マルウェアが他のサーバーへ感染拡大する、漏洩する情報が増えるなど。
- 事業停止の長期化: ECサイトが停止し続け、売上機会を損失する。
- 信用の失墜: 顧客情報が漏洩し、ブランドイメージが大きく損なわれる。
- 法的責任の発生: 法律や契約に基づき、損害賠償を請求される。
こうした最悪の事態を避けるために、インシデントの発生を前提とした対応計画を事前に準備し、組織全体で迅速に行動できる体制を整えておくことが不可欠です。
インシデント対応の全体フロー【NISTの4フェーズ】
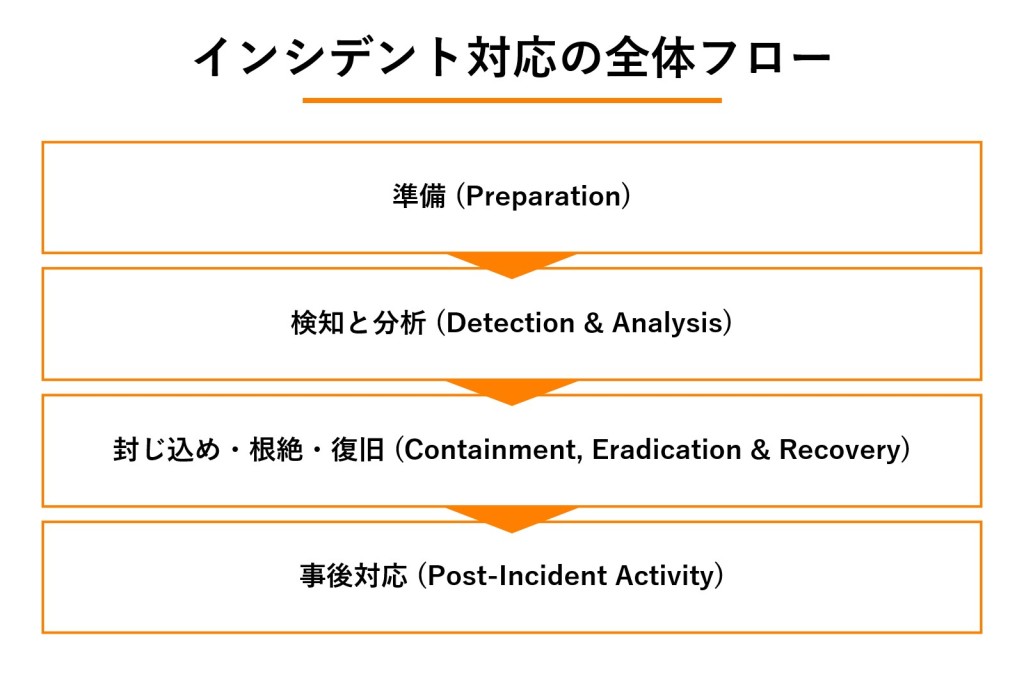
万が一のセキュリティ被害に適切に対処するには、整理された一連の手順を踏むことが不可欠です。
ここでは、米国立標準技術研究所(NIST)が発行するガイドライン「SP800-61 Rev.2(Computer Security Incident Handling Guide)」で示されたインシデント対応のライフサイクルをご紹介します。Rev.3の公開により旧版となりましたが、実務の手順を整理する型として現在も広く参照されているモデルです。
このライフサイクルは、以下の4つのフェーズで構成されています。
| フェーズ | 名称 (英語) | 概要 |
| 1 | 準備 (Preparation) | インシデント発生に備え、計画の策定や体制の構築、ツールの導入などを行う。 |
| 2 | 検知と分析 (Detection & Analysis) | インシデントの兆候を検知し、それが本当にインシデントであるか、どのような影響があるかを分析・評価する。 |
| 3 | 封じ込め・根絶・復旧 (Containment, Eradication & Recovery) | 被害の拡大を防ぐ応急処置(封じ込め)、原因の除去と脆弱性の修正(根絶)、通常運用への復帰と安全性の確認(復旧)を行う。 |
| 4 | 事後対応 (Post-Incident Activity) | 対応のプロセスを振り返り、報告書を作成し、再発防止策を検討・実施する。 |
なお、これらのフェーズは一方通行ではありません。封じ込めの最中に新たな侵害が見つかれば検知と分析に戻り、事後対応で得た教訓は次の準備に活かされます。状況に応じてフェーズを行き来しながら、継続的に対応力を高めていくことがポイントです。
また、NISTは2025年4月にSP800-61の改訂版(Rev.3)を公開しています。Rev.3では、インシデント対応を組織全体のサイバーセキュリティリスク管理の一部として位置づけ、NISTサイバーセキュリティフレームワーク(CSF)2.0の6つの機能(統治・識別・防御・検知・対応・復旧)に沿って整理し直しています。
本記事では、実務の流れをイメージしやすいRev.2のライフサイクルをもとに解説します。
フェーズ1:準備 (Preparation)
インシデント対応は、事が起きてから始まるのではありません。平時にどれだけ備えができているかが、有事の際の対応速度と質を大きく左右します。この「準備」フェーズが最も重要と言っても過言ではないでしょう。
フェーズ2:検知と分析 (Detection & Analysis)
インシデントの兆候(アラート、ユーザーからの報告など)をいち早く捉え、それがどのような事象なのかを正確に分析します。ここで状況を正しく把握できるかが、その後の対応の成否を分けます。
フェーズ3:封じ込め・根絶・復旧 (Containment, Eradication & Recovery)
このフェーズは、被害が広がらないようにする「封じ込め」、原因を取り除く「根絶」、安全な状態に戻す「復旧」の3つの活動で構成されます。状況に応じてこれらを繰り返しながら進める、対応の中核部分です。
フェーズ4:事後対応 (Post-Incident Activity)
インシデントを収束させたら終わりではありません。なぜインシデントが起きたのか、対応に問題はなかったかを振り返り、得られた教訓を次に活かす「事後対応」が不可欠です。ここで作成される報告書や改善策が、組織のセキュリティレベルを一段階引き上げます。
【フェーズ別】インシデント対応で具体的にやるべきこと
それでは、NISTの各フェーズにおいて、具体的にどのようなアクションを取るべきかを見ていきましょう。
【準備】平時に備えるべき4つのこと
準備フェーズでは、インシデントに強い組織を作るための基盤を固めます。特に以下の4点は必ず整備しておきましょう。
| 準備項目 | 具体的なアクション |
| 体制の構築 | ・インシデント対応の責任者やチーム(CSIRT)を任命する ・緊急連絡網を整備し、関係者間で共有する |
| 計画の策定 | ・インシデント対応計画(IRP)を文書化する ・インシデントの重要度を判断する基準を定義する |
| 技術的な対策 | ・セキュリティツール(EDR, SIEM等)を導入・運用する ・システムのバックアップを定期的に取得・検証する |
| 訓練と教育 | ・インシデント対応の机上訓練や演習を定期的に実施する ・全従業員を対象としたセキュリティ教育を行う |
これらの準備を怠ると、いざという時に「誰が」「何を」「どうする」がわからず、初動が大幅に遅れてしまいます。
また、普段からサイバー攻撃の対策を講じたり、定期的にセキュリティ診断を受けて自社の弱点を把握しておくことも、インシデントの発生を未然に防ぐ上で非常に重要です。
関連記事:
脆弱性対策とは?企業が取り組むべき4つのステップを解説!
セキュリティ診断とは?種類や費用、サービスの選び方を徹底解説!
【検知・分析】インシデント発生時の初動対応
インシデントの兆候を検知したら、冷静に初動対応を開始します。
- 第一報と事実確認: 誰が、いつ、どこで、何を発見したのかを正確にヒアリングします。ログの確認なども行い、客観的な事実を集めます。
- トリアージ(優先順位付け): 収集した情報をもとに、インシデントの影響範囲や緊急度を評価し、対応の優先順位を決定します。
- 関係者への連絡: 事前に定めたルールに基づき、責任者や関連部署、経営層へ状況を報告します。過度に情報を隠さず、迅速に共有することが重要です。
この段階では、まだ断片的な情報しかなく焦りがちですが、「事実の記録」と「冷静な分析」を徹底することが、後の対応をスムーズに進める鍵となります。
【封じ込め・根絶・復旧】被害を最小化する手順
分析が完了したら、被害を食い止めるための具体的なアクションに移ります。
- 封じ込め: まずは被害の拡大を防ぐことが最優先です。マルウェアに感染したPCをネットワークから隔離する、侵害されたアカウントをロックするなど、即時的かつ効果的な措置を講じます。
- 根絶: 封じ込めによって時間を稼ぎながら、インシデントの根本原因を特定し、完全に取り除きます。マルウェアの駆除、脆弱性の修正、不正に作成されたアカウントの削除などがこれにあたります。
- 復旧: 根本原因の根絶を確認した後、システムを安全な状態に戻します。クリーンなバックアップからのリストアや、再設定などを行い、正常に稼働することをテストしてからサービスを再開します。
このフェーズでは、証拠保全(フォレンジック調査のため)も意識しながら作業を進めることが重要です。
関連記事:【徹底解説】ログ管理とは?目的や重要性、ツールの選び方までわかりやすく紹介
【事後対応】報告と次に繋げる再発防止策
インシデント対応は、システムを復旧して完了ではありません。将来のインシデントを防ぐための活動が不可欠です。
- インシデント報告書の作成: 対応の経緯、原因、影響、かかったコストなどを時系列で詳細に記録し、報告書としてまとめます。
- 根本原因の分析と再発防止策の立案: 「なぜこのインシデントは起きたのか」を深く掘り下げ、同じ過ちを繰り返さないための具体的な
対策(ルールの見直し、ツールの導入、教育の強化など)を策定します。 - 改善策の実行: 策定した再発防止策を実行に移します。
この学びのサイクルを回すことが、組織をより強く、よりしなやかにするのです。
実効性のあるインシデント対応体制の作り方
ここまで解説したフローをスムーズに実行するためには、しっかりとした「体制」が必要です。ここでは、実効性のある体制を構築するための3つの要素を解説します。
責任者と担当者の役割を明確にする
インシデント発生時に誰が指揮を執り、誰が実務を行うのかが曖昧では、組織は機能しません。
| 役割 | 主な責務 |
| インシデント対応責任者 | ・対応全体の意思決定を行う ・経営層への報告を行う ・対外的なコミュニケーション(プレスリリース等)を管理する |
| インシデント対応担当者 | ・技術的な調査、分析、復旧作業を行う ・対応の進捗を記録し、責任者へ報告する |
| 関連部署の担当者 | ・法務、広報、人事など、専門分野からのサポートを提供する |
これらの役割と責任をあらかじめ定義し、組織図や規定として明文化しておくことが重要です。
CSIRT(シーサート)を組織する
CSIRT(Computer Security Incident Response Team)とは、インシデント対応を専門に行うチームのことで、インシデントの検知から事後対応までを一元的に担います。
CSIRTを設置することで、専門性の高いインシデントにも迅速かつ的確に対応できるようになります。また、24時間365日体制でセキュリティ機器の監視やログ分析を行うSOCとの連携も、早期検知の観点から非常に有効です。
関連記事:SOCとは?企業のセキュリティを守る監視体制の役割や構築方法を解説
インシデント対応計画(IRP)を策定する
インシデント対応計画(Incident Response Plan, IRP)とは、「インシデント発生時に、誰が、何を、どのように行うか」を具体的に定めた行動計画書です。
IRPには、以下のような項目を盛り込みます。
- 対応体制と役割分担
- 緊急連絡網
- インシデントのトリアージ基準
- インシデント種別ごとの対応手順
- 報告のルール(タイミング、報告先、フォーマット)
この計画書があることで、有事の際にも担当者が迷わず行動できるようになります。
インシデント対応を成功に導く3つのポイント
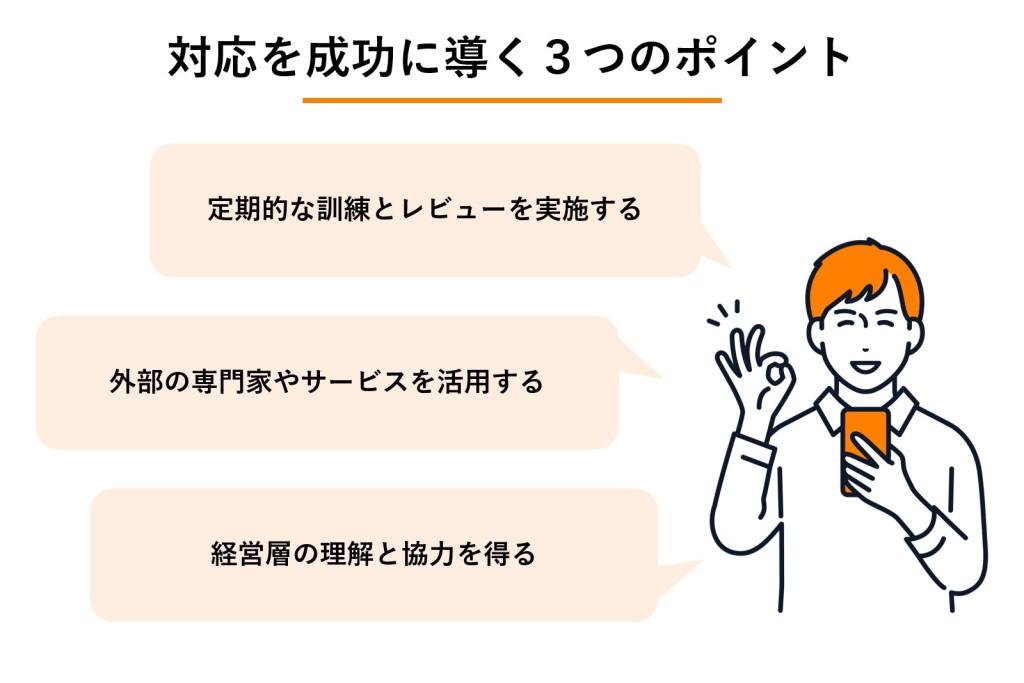
最後に、これまでの内容を踏まえ、インシデント対応を成功させるために特に意識すべき3つのポイントをご紹介します。
定期的な訓練とレビューを実施する
どれだけ素晴らしい計画や体制を整えても、いざという時に動けなければ意味がありません。「特定のシナリオ(例:ランサムウェア感染)を想定した机上訓練」や「実際のシステムを使った実践的な演習」を定期的に実施し、計画の実効性を確認・改善していくことが不可欠です。
外部の専門家やサービスを活用する
すべてのインシデントに自社だけで対応できるとは限りません。高度なサイバー攻撃を受けた場合や、夜間・休日に障害が発生した場合など、自社の体制だけでは迅速な対応が難しいケースもあります。
日頃から、外部の専門サービスと連携できる体制を整えておくと、いざという時に迅速な支援を受けられます。たとえば、サーバーやクラウド環境を24時間365日監視し、異常の検知から初動対応までを担う運用代行サービスを活用すれば、インシデントの早期発見と初動の迅速化につながります。
また、セキュリティインシデントの原因調査が必要な場合は、フォレンジック調査を専門とするベンダーや、MDR(Managed Detection and Response)サービスを活用するのも有効な選択肢です。
DDoS攻撃を受けてもサーバーを落とさず稼働を継続。24時間365日の有人監視で異変をいち早く共有
羽田空港Webサイトのプロデュースおよびプロジェクトマネジメントを担う企業様では、災害時などにアクセスが急増しやすく、24時間365日止まらないサイトを維持するための運用負荷が課題でした。
現在は、WAFやAWS Shield Advancedを組み込み、攻撃に備えたAWS構成でサイトを運用しています。インフラの監視・運用はハートビーツが担当しており、大型台風でアクセスが通常の数十倍に跳ね上がった際も、企業様からの連絡を待たずにハートビーツ側で異変を把握し、状況を共有しました。
2025年には、海外からの攻撃予告に続いてDDoS攻撃を受けましたが、サーバーを落とすことなく稼働を続けられています。
経営層の理解と協力を得る
インシデント対応には、ツールの導入や人材の確保、訓練の実施など、多くのコストとリソースが必要です。これらの投資を実現するためには、セキュリティ対策の重要性を経営層に理解してもらい、協力を得ることが不可欠です。
インシデントが事業に与える影響(事業停止による損失額など)を具体的に示し、予算確保や体制構築へのコミットメントを取り付けましょう。
まとめ
本記事では、インシデント対応の基本から、NISTのガイドラインをもとにした具体的なフロー、そして実効性のある体制構築の方法までを網羅的に解説しました。
今回ご紹介した4つのフェーズを参考に、自社のインシデント対応計画と体制を見直し、万が一の事態に備えてください。
夜間・休日の障害対応やセキュリティ対策の体制づくりに課題を感じている場合は、ITインフラ運用20年以上の豊富な実績を持つハートビーツへお気軽にご相談ください。
ハートビーツの「SecureOps+(セキュアオプスプラス)」は、セキュリティアラートの検知・通知にとどまらず、優先度判断(トリアージ)から影響範囲の整理、対応の推進、再発防止策の提案までを一気通貫で支援する、実運用型のセキュリティ運用支援サービスです。
セキュリティ運用の体制構築や運用負荷の軽減にお悩みの方は、ぜひお気軽にご相談ください。