「Webサイトにアクセスできない」「社内システムが応答しない」など、突然のサーバーダウンはビジネスに深刻な影響を及ぼします。一刻も早い復旧が求められる中、システム担当者は冷静かつ迅速な対応をしなければなりません。しかし、具体的に何から手をつければよいのか分からず、混乱してしまうケースも少なくありません。
本記事では、サーバー障害が発生した際の対応方法を網羅的に解説します。障害の主な原因から、状況確認、原因の切り分け、復旧作業、そして再発防止策までの具体的な手順を7つのステップで紹介します。
この記事のポイント
- サーバー障害発生時は、状況確認から原因の切り分け、暫定・本復旧、再発防止策の策定までを体系的な7つのステップに沿って冷静かつ迅速に進めることが重要である。
- 障害の要因にはアクセス集中やサイバー攻撃、自然災害などの外部要因だけでなく、機器の物理的故障、プログラムの不具合、人為的な操作ミスといった内部要因も存在する。
- 平時からの予防策として、ログやリソース状況を把握できる24時間365日の監視体制の構築、定期的なバックアップ、マニュアル整備、サーバー構成の冗長化が重要である。
- 自社での原因特定や復旧作業が困難な場合は、24時間365日対応や技術的支援が受けられる外部の専門業者(運用代行サービス)を活用することで安定稼働と業務負担の軽減が図れる。
目次
サーバー障害で想定される主な6つの原因
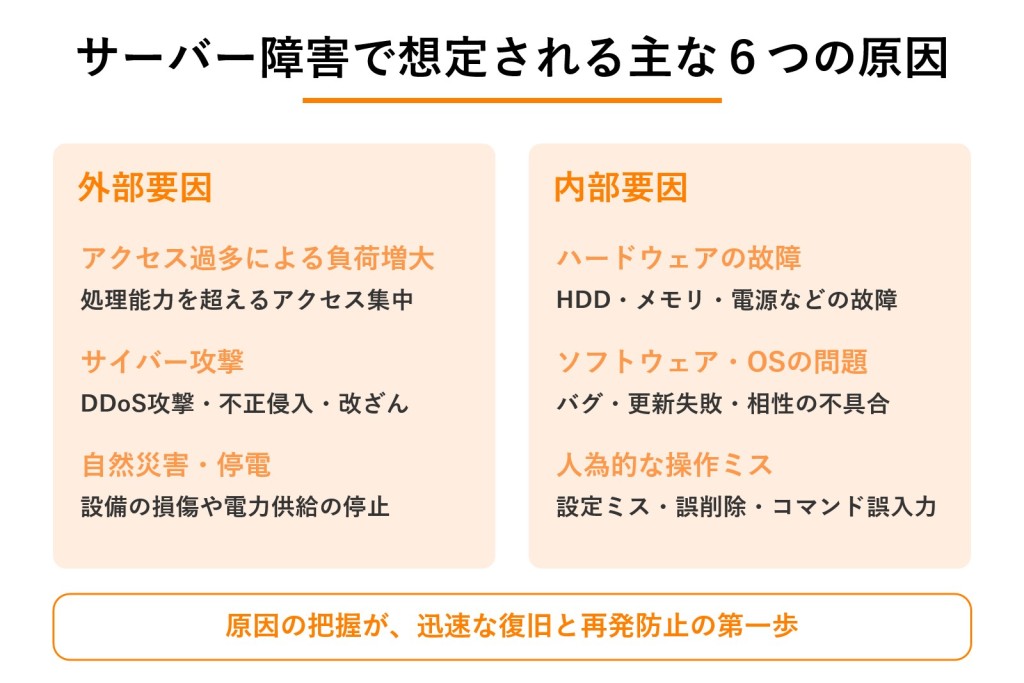
サーバー障害は、様々な要因が複雑に絡み合って発生します。原因を正確に把握することが、迅速な復旧と再発防止の第一歩です。
ここでは、サーバー障害を引き起こす主な6つの原因について解説します。
| 原因の分類 | 具体的な内容 |
| 外部要因 | Webサイトへのアクセス集中、DDoS攻撃などのサイバー攻撃、地震や落雷などの自然災害、停電 |
| 内部要因 | サーバー機器(HDD、メモリ等)の経年劣化や故障、OSやアプリケーションのバグ、設定ミスや誤操作、リソース不足 |
アクセス過多による負荷増大
テレビやSNSで紹介された、あるいはキャンペーンを実施したなどの理由で、Webサイトへのアクセスが急激に増加し、サーバーの処理能力を超えてしまうことがあります。これにより、Webサイトの表示が遅くなったり、完全にダウンしたりする場合があります。
台風時のアクセス急増にも耐える安定稼働を実現
羽田空港Webサイトのプロデュースおよびプロジェクトマネジメントを手掛ける企業様では、自然災害時や交通機関の乱れに伴うアクセス急増のリスクと、24時間体制の運用負荷が課題でした。
アクセス急増に耐えるサーバーレス構成の構築と、24時間365日の有人監視によるインフラ監視の一次切り分けを外部に委託した結果、大型台風でアクセスが通常の数十倍に急増した際や、海外からの攻撃予告に伴うDDoS攻撃を受けた際も、サーバーダウンを起こさず安定稼働を実現しています。
夜間・休日のアラート対応からも解放され、Webサイトの改善やコンテンツの企画立案といったコア業務に注力できるようになりました。
サイバー攻撃などの外部要因
悪意のある第三者によるサイバー攻撃も、サーバー障害の大きな原因の一つです。多数の機器から同時に大量の通信を送り込み、サーバーを麻痺させる「DDoS攻撃」や、サーバーに不正侵入してシステムを破壊したり、データを改ざんしたりする攻撃があります。
関連記事:AWSのDDoS対策を徹底解説|多層防御の設計思想と運用の考え方
ハードウェアの物理的な故障
サーバーは24時間365日稼働しているため、構成するハードウェア(HDD、SSD、メモリ、電源ユニットなど)は常に負荷がかかっています。これらの部品が経年劣化や熱によって物理的に故障すると、サーバーが起動しなくなったり、システムが停止したりする原因となります。
ソフトウェアやOSの問題
サーバー上で動作しているOSやアプリケーションのバグ、プログラムのエラーが原因で障害が発生することもあります。また、ソフトウェアのアップデートに失敗したり、プログラム同士の相性が悪かったりすることも、システムが不安定になる要因です。
人為的な操作ミス
意外に多いのが、システム管理者や開発者の人為的なミスによる障害です。例えば、重要な設定ファイルを誤って削除してしまったり、コマンドの入力を間違えたりといった些細なミスが、システム全体の停止につながることも少なくありません。
自然災害や停電
地震、落雷、洪水といった自然災害によって、データセンターが物理的なダメージを受けたり、大規模な停電が発生したりすることでサーバーが停止するケースです。データセンターは災害対策が施されていますが、100%安全とは限りません。
【緊急時】サーバー障害発生時の対応フロー7ステップ
実際にサーバー障害が発生した場合、パニックにならず、体系立てて対応を進めることが重要です。
ここでは、障害発生から再発防止策の策定までを7つのステップに分けて解説します。
| ステップ | 主な作業内容 |
| Step1 | 障害の検知と状況確認 |
| Step2 | 関係者への一次報告と情報共有 |
| Step3 | 影響範囲の特定 |
| Step4 | 原因の切り分けと特定 |
| Step5 | 応急処置と暫定復旧 |
| Step6 | 恒久対策と本復旧 |
| Step7 | 報告書の作成と再発防止策の策定 |
Step1: 障害の検知と状況確認
まずは「いつから」「どのサーバーで」「どのような事象が」発生しているのかを正確に把握します。監視ツールからのアラート、ユーザーからの問い合わせ、自社スタッフからの報告など、障害を検知するきっかけは様々です。
実際にサーバーにログインを試みたり、Webサイトにアクセスしたりして、現状を自分の目で確認することが重要です。
Step2: 関係者への一次報告と情報共有
障害の発生を確認したら、速やかに関係各所へ第一報を入れます。上司や関連部署、必要であれば顧客に対しても、「障害が発生していること」「現在調査中であること」を伝えます。
これにより、問い合わせの集中を防ぎ、復旧作業に専念できる環境を確保します。
Step3: 影響範囲の特定
次に、その障害がどの範囲に影響を及ぼしているのかを特定します。特定のサービスだけか、複数のシステムにまたがっているのか、あるいは全社的な問題なのかを切り分けます。
影響範囲を明確にすることで、対応の優先順位を判断し、リソースを適切に配分できます。
Step4: 原因の切り分けと特定
影響範囲が特定できたら、具体的な原因究明に移ります。「サーバー障害の原因を特定する切り分け方法」で後述するように、ログの確認やリソース状況のチェックを行い、原因を絞り込んでいきます。ハードウェア、ソフトウェア、ネットワークなど、様々な角度から可能性を探ります。
Step5: 応急処置と暫定復旧
原因の特定に時間がかかる場合でも、まずはサービスを一時的にでも再開させるための応急処置を優先します。例えば、サーバーの再起動、不要なプロセスの停止、代替機への切り替えなどが考えられます。
この段階では、完全な復旧を目指すのではなく、ビジネスへの影響を最小限に食い止めることが目的です。
Step6: 恒久対策と本復旧
暫定復旧で時間を確保したのち、根本的な原因を取り除くための恒久対策を実施します。故障したハードウェアの交換、ソフトウェアのバグ修正、セキュリティパッチの適用など、原因に応じた本格的な復旧作業を行います。
Step7: 報告書の作成と再発防止策の策定
障害が完全に復旧したら、事後対応として障害報告書を作成します。発生日時、影響範囲、原因、対応内容、今後の再発防止策などを時系列で詳細に記録します。
この記録を組織全体で共有し、分析することで、将来同様の障害が起こるのを防ぎます。
サーバー障害の原因を特定する切り分け方法
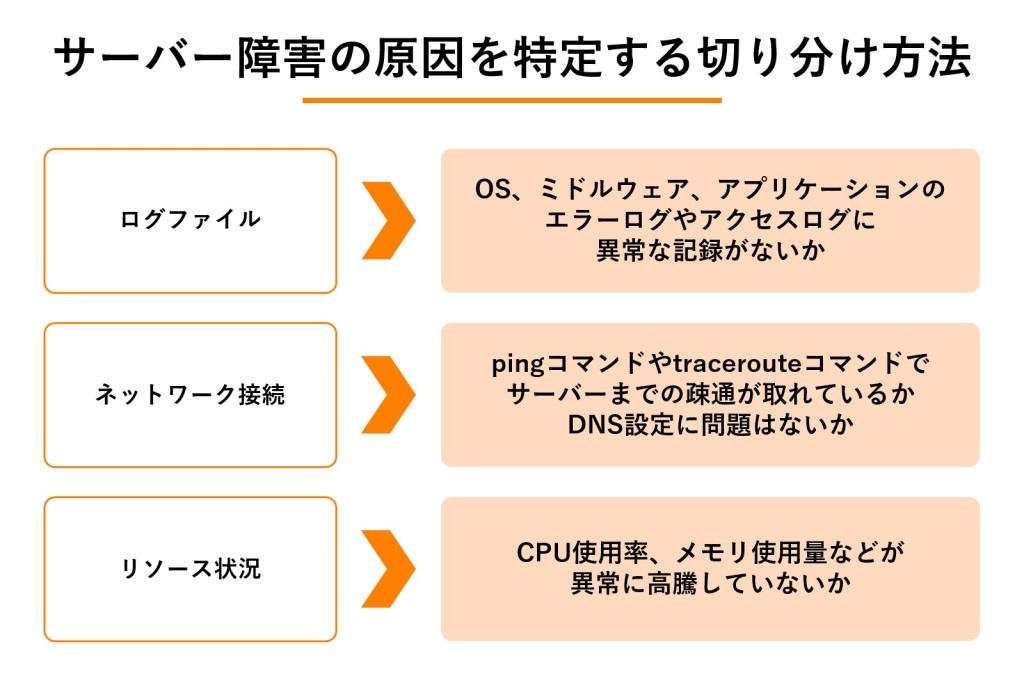
サーバー障害の原因は多岐にわたるため、闇雲に調査しても解決には至りません。以下の方法を用いて、効率的に原因を切り分けていくことが重要です。
| 確認項目 | チェックする内容 |
| ログファイル | OS、ミドルウェア、アプリケーションのエラーログやアクセスログに異常な記録がないか |
| ネットワーク接続 | pingコマンドやtracerouteコマンドでサーバーまでの疎通が取れているか、DNS設定に問題はないか |
| リソース状況 | CPU使用率、メモリ使用量などが異常に高騰していないか |
ログファイルを確認する
サーバーは、OSやアプリケーションの動作記録を「ログ」として残しています。特にエラーログには、障害の直接的な原因が記録されていることが多いため、必ず確認しましょう。
どの時間帯に、どのプログラムが、どのようなエラーを出力しているかを調べることで、原因特定の大きな手がかりとなります。
ネットワーク接続をチェックする
サーバー自体は正常に稼働していても、ネットワークの問題でアクセスできなくなっている可能性もあります。
まずはサーバーへpingコマンドを送り、応答があるかを確認します。応答がない場合は、ルーターやスイッチなどのネットワーク機器の故障、ファイアウォールの設定ミスなどが考えられます。
リソース(CPU・メモリ)の使用状況を調べる
アクセス集中やプログラムの不具合によって、サーバーのCPUやメモリなどのリソースが枯渇し、システムが応答しなくなることがあります。
topやhtopといったコマンドを使って、どのプロセスのリソース使用率が高いのかを特定します。異常にリソースを消費しているプロセスがあれば、それが障害の原因である可能性が高いです。
日頃から実施すべきサーバー障害への4つの備え
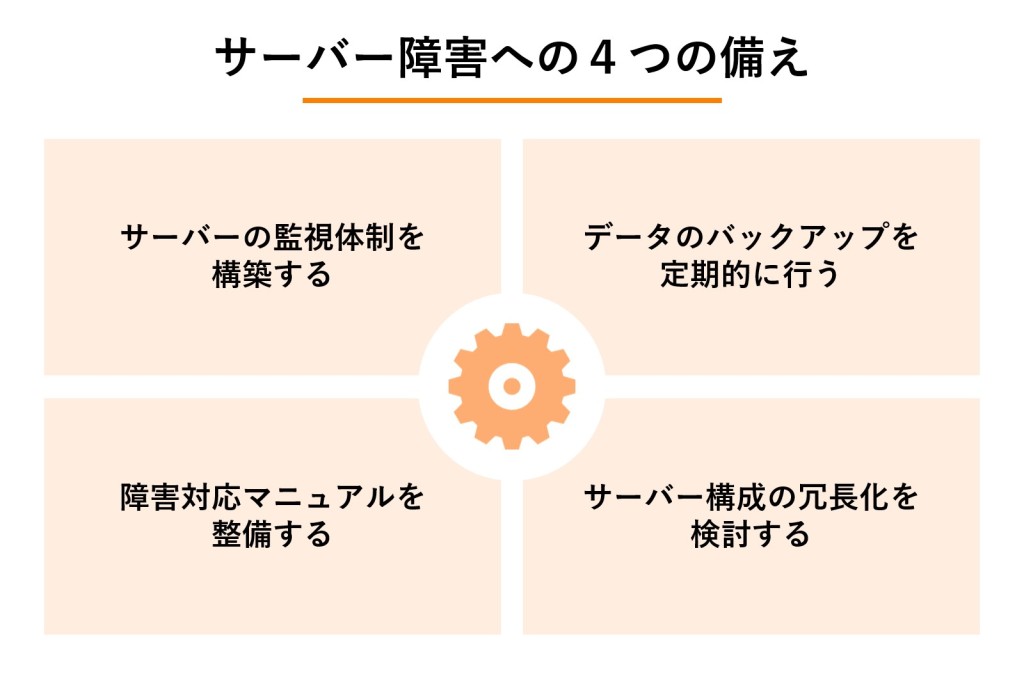
障害は突然発生しますが、日頃からの備えによって、そのリスクを低減し、発生時の影響を最小限に抑えることができます。システム担当者が平時から実施しておくべき4つの対策を紹介します。
| 対策項目 | 目的 |
| 監視体制の構築 | 障害の兆候を早期に検知し、迅速な対応を可能にする |
| 定期的なバックアップ | データの損失を防ぎ、迅速なデータ復旧を実現する |
| マニュアルの整備 | 属人化を防ぎ、誰でも一定水準の対応ができるようにする |
| サーバー構成の冗長化 | 1台のサーバーが停止しても、サービスを継続できるようにする |
サーバーの監視体制を構築する
サーバーの死活監視やリソース監視を行うツールを導入し、24時間365日体制でサーバーの状態を監視することが最も重要です。
CPU使用率やメモリ使用量などに閾値を設定し、超えた場合にアラートが通知されるようにしておけば、障害が発生する前兆を捉え、迅速な対応が可能になります。
関連記事:インフラ監視とは?監視項目・導入目的からツールの選び方まで基本を解説
データのバックアップを定期的に行う
ハードウェアの故障や人為的ミス、サイバー攻撃などによって、重要なデータが失われるリスクは常に存在します。万が一に備え、重要なデータは必ず定期的にバックアップを取得しましょう。
バックアップデータは、サーバー本体とは物理的に異なる場所(遠隔地のデータセンターやクラウドストレージなど)に保管することが推奨されます。
障害対応マニュアルを整備する
障害発生時の対応フロー、連絡体制、確認事項などをまとめたマニュアルを事前に作成しておきましょう。マニュアルがあれば、担当者が不在の場合でも、他の人が迅速かつ的確な初期対応を行えます。
対応手順が標準化されることで、属人化を防ぎ、組織全体の対応力を向上させることができます。
サーバー構成の冗長化を検討する
ミッションクリティカルなシステムでは、サーバー構成の冗長化が有効です。
例えば、同じ構成のサーバーを2台用意して負荷分散を行ったり(ロードバランシング)、メイン機に障害が起きた際に自動で待機機に切り替わる仕組み(フェイルオーバー)を構築したりすることで、サービスの可用性を高めることができます。
関連記事:AWSにおける可用性とは?設計の基本や高可用性を実現する方法を解説
自社での対応が困難な場合は専門業者への依頼も検討しよう
サーバー障害の原因は複雑で、自社の担当者だけでは原因特定や復旧が困難なケースも少なくありません。対応が長引けばビジネスへの影響も拡大してしまいます。そのような場合は、無理せず外部の障害対応サービスを利用することも有効な選択肢です。
専門業者に依頼するメリット
専門業者に依頼する最大のメリットは、経験豊富なエンジニアによる迅速かつ的確な対応が期待できる点です。24時間365日対応してくれる業者も多く、深夜や休日に障害が発生した場合でも安心です。
また、自社の担当者が本来の業務に集中できるという利点もあります。
業者選定で確認すべきポイント
障害対応を外部に委託する際は、以下の点を確認して業者を選定しましょう。
- 対応時間: 24時間365日対応可能か
- 対応範囲: どこまでの復旧作業を依頼できるか(原因調査、応急処置、恒久対応など)
- 実績: 自社と同じような業種やシステム規模での対応実績が豊富か
- 料金体系: どこからが有料になるのか、料金体系が明確か
コスト面での判断から委託先を変更したものの、「技術的な相談のしやすさ」を重視するように
SaaSプロダクトを提供する企業様では、監視とAWS請求代行をまとめて依頼できる別の会社のほうがコスト面で有利と判断し、委託先を変更しました。しかし変更後は、質問に明確な回答が得られなかったり、逆に質問される場面が増えたりと、負担が増えたとのこと。
さらにIPv6への切り替え後に監視が度々止まる事象が起き、繰り返し依頼しても根本的な解決に至らなかったため、もともとご利用いただいていたハートビーツへ再度ご依頼いただきました。
24時間365日の有人監視で業務時間外の対応を任せられ、技術的な質問にもわかりやすい説明が得られるとご評価いただいております。同社では今、委託先を選ぶ際に、インフラについて技術的な相談がどこまでできるか、説明がわかりやすいかを何より重視しているそうです。
障害はいつ起こるかわかりません。万が一の事態に備え、事前に信頼できる業者をリストアップしておくと、いざという時にスムーズに依頼できます。
関連記事:インフラ運用代行とは?メリット・費用相場と失敗しない業者の選び方