
アマゾン ウェブ サービス ジャパン合同会社(以下「AWS ジャパン」)が運営する「AWS JAPAN APN ブログ」にて、AWS DevOps エージェントをMSP(Managed Service Provider)運用(アラート調査業務)に適用した検証事例が掲載されましたので、お知らせいたします。
クラウドインフラの運用現場では、24時間体制の監視アラート対応がエンジニアの大きな負担となっています。
ハートビーツは、AIエージェントを活用したMSP運用の一次対応(アラート調査業務)において、シニアエンジニアの「最初の見立て」を自動提示する仕組みをアマゾン ウェブ サービス(AWS)上に構築し、検証を実施しました。
顧客システムを預かる立場から、本取り組みは「調査はAI、判断は人」というadvise-onlyを原則とし、AIエージェントが行うのは読み取りによる調査と、見立て・推奨手順の提示までにとどめています。read-onlyと案件分離によって安全性を技術的に担保しています。
本検証では、これまで当番エンジニアがサーバーへログインして行い、1件あたり約10〜20分を要していた一次切り分けにAIエージェントを活用し、発報から約2〜3分で見立てがチャットツールに届くようになりました。
ハートビーツは、AWS MSSP(Managed Security Service Provider)コンピテンシーパートナーとして AWS でのマネージドセキュリティサービスを提供するとともに、マルチクラウド/オンプレミス環境での24時間365日のMSPサービスを手掛けています。今回の取り組みにより、どの案件でも一定品質の初動を数分で提供できる見通しが得られました。
※記載の数値は、当社社内システム(9案件・計36台)を対象としたパイロット検証の結果です。一次切り分けにかかる時間が1件あたり約10〜20分から約2〜3分に短縮されたことをもとに、「50%以上の効率化」と算出しています。
「AWS DevOps エージェント」とは
詳しくはこちらを参照ください。
取り組みの背景
ハートビーツの運用チームでは、監視アラートが発報するたびに、当番エンジニアがサーバーへログインして手順書に基づき負荷・ディスク・ログなどを確認し、過去の対応履歴と突き合わせる――という一次切り分けを人手で行ってきました。この初動は1件あたり約10〜20分を要し、案件が増える中で、調査の負担を抑えつつ、初動の品質を揃える必要がありました。また、監視仕様や過去の対応履歴が複数のツールに分散していることや、担当者の経験への依存も課題となっていました。
この一次切り分けに AWS DevOps エージェントを適用し、発報から数分で「最初の見立て」を自動提示する仕組みを構築・検証しました。
取り組みの概要
アーキテクチャーと運用設計
Nagios などの監視システムはそのまま稼働させつつ、アラートを共通形式に正規化し、案件ごとの Agent Space へ振り分ける仕組み(アラート受付基盤)を新たに AWS 上に構築しました。案件コードを識別子として監視・チケット・エージェントを1つのコードで結び、重複排除やフラッピング時の調査抑止、関連アラートの集約といったノイズ制御を行うほか、Google Cloud、Azure、オンプレミスの環境も同じフローに載せています。
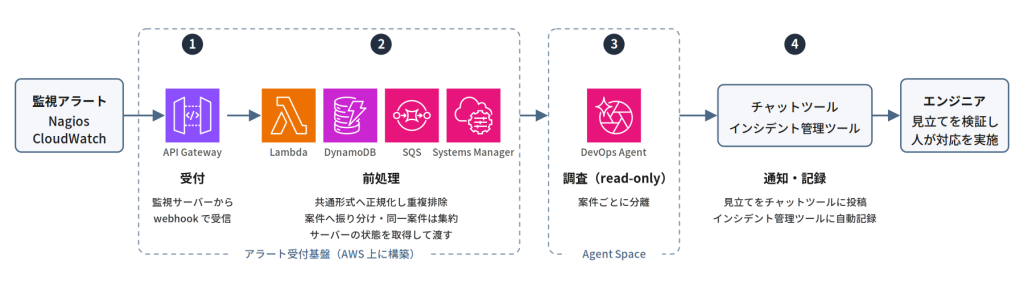
図.AWS DevOps Agent によるアラート調査フロー
セキュリティ面では、Agent Space と参照用 IAM ロール・Skills(エージェントが調査時に参照する知識)の案件単位分離、読み取り専用のガードレール、出力先の制限と監査ログによる確認により、エージェントの行動範囲を運用ルールではなく技術で制限しています。
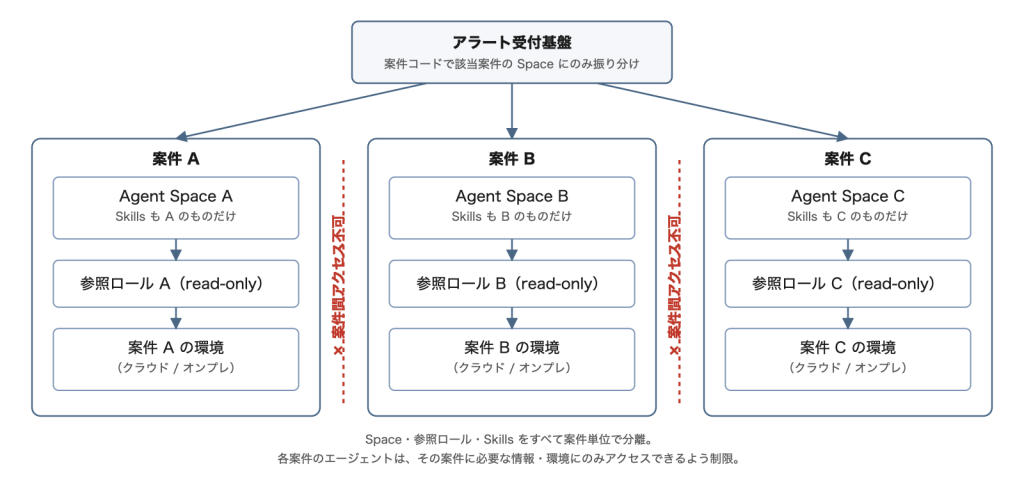
図.Agent Space による案件単位の分離設計
検証結果
社内で運用する9案件・計36台(Amazon Elastic Compute Cloud⦅Amazon EC2⦆、Azure上のVMを含む)を対象にパイロット検証を行い、調査を30件実行しました。当初は、発報した指標の判定は正確な一方で、ディスクの逼迫やサービスの停止といった周辺の異常を見落とすことがありました。原因はエージェントの能力ではなく、渡す情報と指示の不足にありました。これらを段階的に改善した結果、評価対象としたすべての調査で、運用チームが一次切り分けに使える水準の見立てを確認できました。最大の変化は、当番の仕事が「ゼロから調べる」から「見立てを検証する」へ変わったことです。
| 観点 | 従来(手作業) | 導入後(社内での実運用) |
| 一次切り分け | 当番がサーバーへログインして調査(1件 約10〜20分) | 発報から約2〜3分で見立てがチャットツールに届き、当番は内容の検証から始められる |
| 過去の対応履歴の確認 | 複数のツールを人が横断検索 | 監視仕様書・過去の対応履歴を Skills としてあらかじめ登録し、それらを踏まえた見立てを自動提示 |
| 緊急度の低いアラート対応 | アラートが多く人的負荷が高い | 簡易調査の結果を当番が確認し、対応の要否を判断 |
| 初動品質 | 担当のスキル・経験に依存 | 評価対象の調査で、一次切り分けに使える見立てを確認 |
| 障害情報の鮮度 | 調査着手までに状態が変化し、発報時の情報を確認しにくい場合がある | 発報を契機に情報を取得し、発報時に近い状態を調査に利用 |
具体例として、深夜23時台に、AWS・Google Cloud・Azureの3つのクラウドにまたがる社内データベースクラスタの1台で、レプリケーションの異常を検知するアラートが発報したケースがあります。エージェントはまずCPU・メモリ・ディスクの実測値からOS側に異常がないことを確かめ、サーバーではなくレプリケーション機能そのものの障害と高い確信度で絞り込みました。さらに、3日前に同じクラスタの別ノードで発報していた疎通異常を前兆の可能性として指摘し、自動セキュリティ更新が数週間失敗し続けているという隠れた問題も発見しています。推奨手順にはプライマリノードの場合の運用上の注意点まで含まれ、発報からレポートの到着まで2分53秒で完了しました。経験豊富なシニアエンジニアが行うような観点を含む見立てとして、実用水準に達しています。
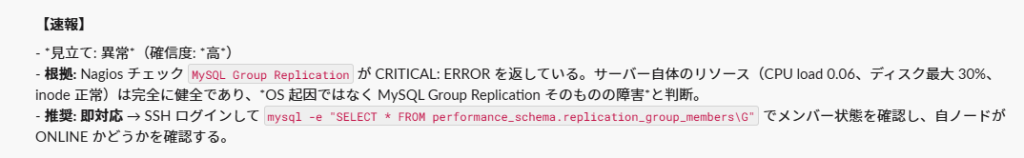
図.レプリケーション障害のトラブルシューティング
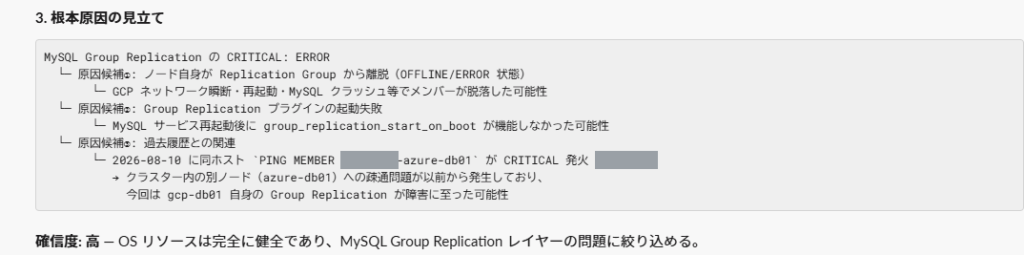
図.根本原因の信頼度評価
今後の展望
ハートビーツは、AIエージェントを「人の判断を置き換えるもの」ではなく「エンジニアの初動を戦力増幅するもの」と位置づけています。
現在は社内システムでの実運用に加えて、顧客案件への展開を進めています。顧客環境に変更を加えない範囲から始め、了承をいただいた案件から順次広げています。中期的には、過去のチケットやメール履歴との連携で見立ての根拠をさらに厚くし、どの顧客・どの環境からのアラートでも、発報した瞬間に信頼できる最初の見立てが届く状態を目指します。
このように、ハートビーツはAIを駆使しながら、実運用に適したセキュリティ設計にも配慮し、AWS を使用するお客様が安心して事業を運営できるよう、MSPサービスを日々進化させてまいります。
※本取り組みの詳細は、AWS ジャパンが運営する「AWS JAPAN APN ブログ」にてご紹介いただいています。